Socket.IO 10,000명 재연결 부하 테스트
- Socket
- thundering-herd
- load-testing
들어가며
실시간 화상 강의 서비스 Plum의 소켓 재연결 옵션을 다듬던 중, 팀 리뷰에서 "재연결 간격을 더 느슨하게 잡자"는 의견을 받았다. Plum은 비대면 강의의 단방향 소통 문제를 풀기 위해 mediasoup(WebRTC) 기반으로 만든 서비스다. 재연결 속도를 빠르게 하면 사용자 경험은 좋아지지만, 그만큼 서버에 동시 재연결 요청이 몰릴 수 있다.
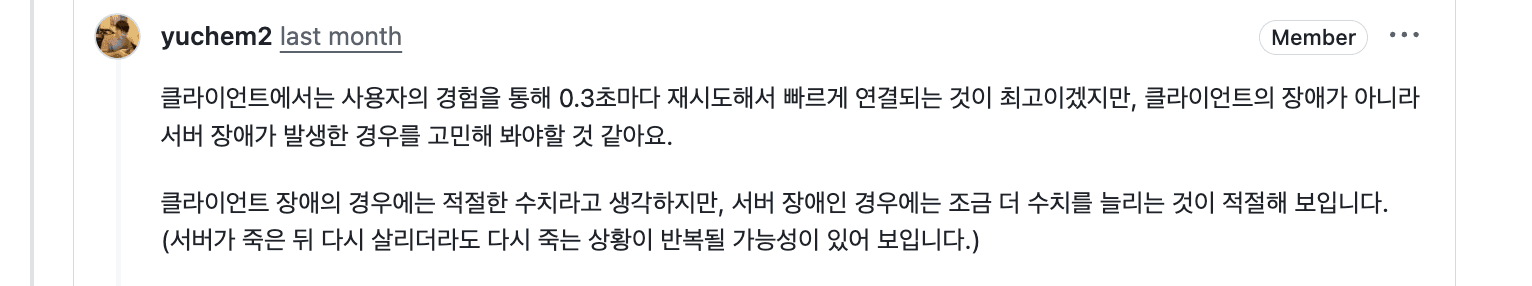
이론적으로는 두 주장 모두 타당하다. 어느 쪽이 맞는지 판단하려면 실제 서버가 어느 정도 부하까지 버티는지 데이터로 확인해야 했다. PR에서 제안한 설정값이 유효한지 검증하고, 이를 바탕으로 최종 방향을 결정하는 것이 이 테스트의 목적이다.
| 옵션 | 설명 | 기존 설정 | PR 제안값 |
|---|---|---|---|
| reconnectionDelay | 최초 재연결 시도 지연 시간 | 1,000ms | 300ms |
| reconnectionDelayMax | 재연결 시도 간격의 최대치 | 5,000ms | 3,000ms |
| randomizationFactor | 재연결 간격의 무작위 분산 비율 | 0.5 | 0.3 |
서버의 모든 연결이 한 번에 끊기고 10,000명이 동시에 다시 붙으려 할 때, 이 설정은 어디까지 버틸 수 있을까?
끊김을 재현할 테스트 환경
전체 연결이 한 번에 끊기는 순간을 재현하려면 세 가지가 필요했다. 실제와 같은 클라이언트로 부하를 만들고, 원하는 시점에 연결을 끊고, 그 부하를 OS가 받아줄 수 있어야 한다.
부하 생성은 Artillery로 했다. Node.js 기반이라 프로덕션과 같은 socket.io-client를 그대로 쓸 수 있고, reconnect_attempt 이벤트와 ACK 콜백, 커스텀 히스토그램 메트릭까지 시나리오 하나 안에서 처리할 수 있다. k6, JMeter, Locust로는 이 조합을 만들 수 없었다.
연결 끊기는 Toxiproxy가 맡았다. TCP 프록시라 스크립트에서 HTTP API로 reset_peer toxic을 넣으면 모든 연결에 RST를 즉시 보내 disconnect 이벤트를 정확한 시점에 일으킬 수 있다. iptables DROP은 클라이언트가 타임아웃까지 기다리게 만들어 제외했다.
서버는 Linux VM(UTM) 에 올렸다. somaxconn은 listen()을 호출한 소켓이 동시에 대기시킬 수 있는 pending 연결 큐의 최대 길이를 정하는 커널 파라미터다. macOS는 kern.ipc.somaxconn=128이라 WebSocket 연결이 OS 단계에서 먼저 거부되어 10,000 VU 테스트를 할 수 없었다. 그래서 Linux VM에서 net.core.somaxconn=4096으로 올려 클라우드와 같은 조건을 맞췄고, Artillery와 NestJS를 따로 실행해 CPU 경쟁이 측정을 흐리지 않게 했다.
테스트는 두 단계로 나눴다. 여러 값을 한 번에 바꾸면 어떤 변경이 효과를 냈는지 알 수 없어서 변수를 하나씩 떼어 보기 위해서다. Phase 1은 자동 재연결을 끄고 1회만 수동으로 재연결해, 첫 시도의 실패를 곧 최종 실패로 보고 최악의 임계 지점을 찾는다. Phase 2는 거기서 찾은 원인만 최소한의 설정 변경으로 고친 뒤 같은 조건에서 다시 잰다.
재연결이 한꺼번에 몰리면 생기는 일
서버 장애 뒤 모든 클라이언트가 동시에 재연결을 시도해 부하가 한순간에 몰리는 현상을 Thundering Herd라고 한다. 접속자가 많다는 것 자체보다 요청이 특정 시점에 몰린다는 점이 문제다.
이를 완화하는 장치가 jitter다. Socket.IO의 randomizationFactor는 재연결 타이밍에 무작위성을 더해 요청을 시간 축으로 흩어놓는다. 분산 윈도우는 reconnectionDelay × 2 × randomizationFactor이고, 피크 속도는 접속자 수를 이 윈도우(초)로 나눈 값이다. reconnectionDelay=300ms, 1,000명 기준으로 계산하면 아래와 같다.
| randomizationFactor | 분산 윈도우 | 1,000명 피크 속도 |
|---|---|---|
| 0 (없음) | 0ms | ∞ (순간 스파이크) |
| 0.3 (Phase 1) | 180ms | 5,556 req/s |
| 0.5 (Phase 2) | 300ms | 3,333 req/s |
재연결이 계속 실패하면 지수 백오프가 대기 시간을 매번 두 배로 늘려 서버가 회복할 시간을 번다. reconnectionDelayMax에 닿으면 그 값에서 멈추고, 각 시도에는 다시 jitter가 붙어 실제 대기 시간은 아래 값을 기준으로 흩어진다. 상한이 5,000ms일 때는 이렇게 늘어난다.
| 시도 | 계산 | 대기 시간 |
|---|---|---|
| 1차 | 300ms × 2⁰ | 300ms |
| 2차 | 300ms × 2¹ | 600ms |
| 3차 | 300ms × 2² | 1,200ms |
| 4차 | 300ms × 2³ | 2,400ms |
| 5차+ | (상한 도달) | 5,000ms |
Phase 1: 10,000명에서 재연결 성공률이 64.5%로 떨어졌다
PR 제안값을 적용한 상태에서, 자동 재연결을 끄고 1회만 수동으로 재연결하게 했다.
| 옵션 | 설명 | 값 |
|---|---|---|
| reconnectionDelay | 최초 재연결 시도 지연 | 300ms |
| reconnectionDelayMax | 재연결 간격 최대치 | 3,000ms |
| randomizationFactor | 분산 윈도우 180ms | 0.3 |
| SOCKET_TIMEOUT | Redis 세션 유지 시간 (TTL) | 5s |
5,000명까지는 버텼다
| 목표 VU | 실제 연결 | 성공 | 실패 | 성공률 |
|---|---|---|---|---|
| 100 | 100 | 100 | 0 | 100% |
| 500 | 500 | 500 | 0 | 100% |
| 1,000 | 1,000 | 1,000 | 0 | 100% |
| 5,000 | 4,892 | 4,892 | 0 | 100% |
| 10,000 | 6,999 | 4,516 | 2,483 | 64.5% |
| 목표 VU | p50 | p95 | p99 | max |
|---|---|---|---|---|
| 100 | 0.3s | 0.4s | 0.4s | 0.4s |
| 500 | 0.3s | 0.4s | 0.4s | 0.4s |
| 1,000 | 0.3s | 0.4s | 0.4s | 0.4s |
| 5,000 | 0.3s | 0.4s | 0.5s | 0.5s |
| 10,000 | 2.1s | 4.1s | 6.6s | 8.8s |
5,000 VU까지는 재연결 성공률이 100%였고, p50도 VU 수와 상관없이 0.3s로 일정했다. 5,000 VU부터는 초기 연결 단계에서 TCP Backlog 포화로 일부가 탈락했지만, 연결에 성공한 세션은 모두 돌아왔다. 성공률의 분모를 목표 VU가 아니라 초기 연결에 성공한 실제 연결 수로 잡은 이유다. 10,000 VU에서는 달랐다. 6,999명 중 2,483명이 돌아오지 못했고, p50은 TCP Backlog 경쟁으로 재전송이 쌓이며 2.1s까지 치솟았다.
무너진 지점은 재연결 순간의 TCP Backlog였다
문제는 초기 연결에서 먼저 드러났다. 10,000개의 연결 요청이 한꺼번에 몰려 somaxconn=4096으로 늘린 TCP Backlog도 포화됐고, 3,001건이 탈락해 6,999명만 연결에 성공했다. 연결 뒤에는 6,999건의 join_room이 한 강의실로 동시에 몰려 이벤트 루프가 밀렸고, 일부 VU가 응답을 받지 못했다. 다만 이건 모든 VU를 한 방에 넣은 테스트 구조가 부풀린 fan-out이라 실제 서비스에서는 나타나지 않는다.
핵심은 재연결 순간이다. 연결에 성공한 6,999명이 RST를 받은 뒤 jitter=0.3(윈도우 180ms) 안에서 동시에 재연결을 시도했다. 초당 38,883건의 연결이 몰리며 TCP Backlog가 다시 포화됐고, 2,483건이 추가로 거부됐다. 앞에서 본 64.5%가 바로 이 숫자에서 나왔다.
Phase 1은 자동 재연결을 껐으니 거부된 VU는 거기서 끝난다. 그렇다면 자동 재연결을 켰을 때 지수 백오프가 이들을 살릴 수 있었을까? 누적 대기 시간을 계산해보면 Redis 세션 TTL(5s) 이 그 기회를 막는다. jitter=0.3 기준으로 4차 시도 무렵 누적 대기가 TTL을 넘어, TCP 연결에 성공해도 세션이 이미 만료되어 join_room이 실패한다.
| 시도 | 계산 | 대기 시간 | 누적 최대 |
|---|---|---|---|
| 1차 | 300ms × 2⁰ | 300ms | 390ms |
| 2차 | 300ms × 2¹ | 600ms | 1,170ms |
| 3차 | 300ms × 2² | 1,200ms | 2,730ms |
| 4차 | 300ms × 2³ | 2,400ms | 5,850ms ← TTL 초과 |
결국 풀어야 할 원인은 두 가지로 좁혀졌다. 재연결 요청을 180ms보다 넓게 흩어야 하고, 백오프가 끝나기 전에 세션이 사라지지 않아야 한다.
Phase 2: jitter와 세션 TTL을 바꾸자 100%가 됐다
원인 하나에 옵션 하나
두 원인에 직접 대응하는 옵션만 조정했다.
| 항목 | 변경 전 | 변경 후 | 근거 |
|---|---|---|---|
| randomizationFactor | 0.3 | 0.5 | 분산 윈도우 180ms → 300ms, 피크 38,883 → 23,330 req/s |
| SOCKET_TIMEOUT | 5s | 30s | 지수 백오프 5차 누적 최대(~14s)의 2배 이상 확보 |
| reconnectionDelayMax | 3,000ms | 5,000ms | 2차 이상 재시도 시 요청 밀집도 완화 |
| reconnectionDelay | 300ms | 300ms | UX 유지. 부하 분산은 jitter가 담당 |
reconnectionDelay는 300ms 그대로 뒀다. 1,000 VU 이하의 재연결은 일반적인 네트워크 불안정으로 보고, 이때는 빠르게 돌아오는 UX가 우선이라고 판단했다. 대규모 동시 재연결은 jitter=0.5가 시간 축으로 흩어주니 설정 하나로 두 상황을 모두 덮을 수 있다. 일반 복구는 빠르게, 전체 재연결은 jitter로 분산하는 것이 의도였다.
SOCKET_TIMEOUT은 30s로 올렸다. 세션 TTL은 클라이언트의 백오프 사이클뿐 아니라 서버 복구 시간도 덮어야 한다. PM2 재시작이나 도커 컨테이너 재배포로 생기는 다운타임은 수 초에서 수십 초에 이른다. 30s는 백오프 5차 누적 최대(~14s)의 두 배가 넘으면서 일반적인 서버 재시작까지 흡수할 수 있는 값이다.
| 시도 | 대기 시간 | 누적 최대 |
|---|---|---|
| 1차 | 300ms | 450ms |
| 2차 | 600ms | 1,350ms |
| 3차 | 1,200ms | 3,150ms |
| 4차 | 2,400ms | 6,750ms |
| 5차 | 4,800ms | 13,950ms ← TTL 30s 이내 |
10,000명 전원이 첫 시도에 돌아왔다
jitter=0.5로 분산 윈도우를 넓히자 피크가 38,883 → 23,330 req/s로 줄며 TCP Backlog 포화가 아예 일어나지 않았다. 6,999건 전원이 첫 시도의 jitter 대기 시간(150~450ms) 안에 처리됐고, 지수 백오프가 2차 재시도에 나설 일도 없었다. 재연결 성공률은 64.5%에서 100% 가 됐고, 지연 시간 분포도 1,000 VU 수준으로 모였다.
1,000 VU에서는 성공률 100%를 유지하고 p99만 0.1s 늘었다. 분산 윈도우가 넓어진 만큼 생긴 자연스러운 변화로, 사용자가 느끼기 어려운 수준이다.
| 항목 | Phase 1 | Phase 2 | 차이 |
|---|---|---|---|
| 재연결 성공률 | 100% | 100% | - |
| p50 | 0.30s | 0.30s | - |
| p99 | 0.40s | 0.50s | +0.10s |
| max | 0.40s | 0.50s | +0.10s |
정리하며
결과적으로 "재연결 간격을 더 느슨하게 잡자"는 리뷰 의견이 맞았다. PR은 재연결을 빠르게 하려고 jitter를 0.5에서 0.3으로, 상한을 5,000ms에서 3,000ms로 조였다. 하지만 10,000명 규모에서는 바로 그 조임이 TCP Backlog를 다시 포화시켰다. 최종 설정은 두 값을 원래대로 되돌리고, 빨라진 reconnectionDelay 300ms와 늘린 SOCKET_TIMEOUT 30s만 가져갔다.
단일 설정 하나가 시스템 전체 흐름을 바꿀 수 있다는 것도 확인했다. 가장 임팩트가 컸던 변경은 jitter 확대였다. randomizationFactor 한 줄이 TCP Backlog 포화 자체를 막았고, SOCKET_TIMEOUT 상향은 TTL 만료라는 2차 실패 경로를 없앴다. 두 변경 모두 단독으로는 불완전했고, 맞물려야 효과가 났다.
구조적 한계와 설정으로 풀 수 있는 한계는 구분해야 한다. 단일 인스턴스의 초기 수용 한계(~7,000연결)는 TCP Backlog의 구조적 한계로, 방 구조와 무관하게 전체 동시 접속자 총량에 달려 있어 설정 조정만으로는 풀 수 없다. 서비스 규모가 이 수준에 가까워지면 수평 확장이나 연결 분산 전략이 필요하다. 반면 일단 연결에 성공한 세션의 재연결은 현재 설정으로 10,000 VU에서도 100% 복구할 수 있었다.
이론보다 재현 가능한 실험이 더 강한 판단 근거가 된다는 점도 다시 느꼈다. 이론으로는 양쪽 주장 모두 타당했고, 재연결 순간의 Backlog 재포화나 TTL과 백오프가 맞물리는 문제는 추측만으로는 찾기 어려웠다. 다음에도 설정 하나를 바꿀 때 근거를 데이터로 확인하는 습관을 이어가고 싶다.